Lara Ljubičić o medijima, Big Techu i AI-ju
Publika do medijskog sadržaja sve češće dolazi preko tražilica, društvenih mreža i alata generativne umjetne inteligencije. Istodobno, AI modeli treniraju se na milijunima tekstova, među kojima su i novinski članci, dok njihovi autori i izdavači često ni ne znaju je li njihov sadržaj završio u nekom skupu podataka.
Pa tko danas zapravo kontrolira sadržaj na internetu?
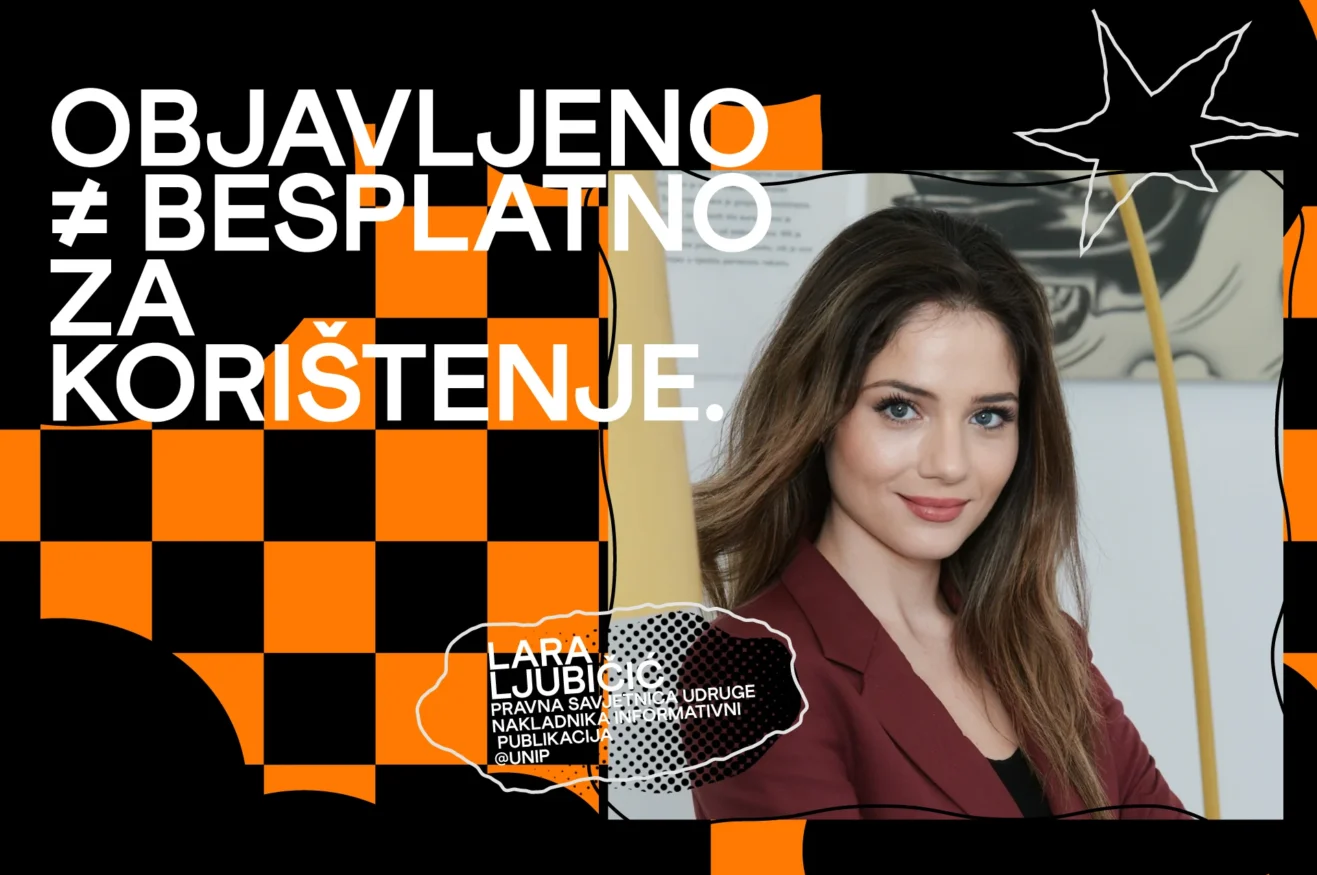
O odnosu velikih tehnoloških platformi i medija, granicama dopuštenog korištenja digitalnog sadržaja i pravilima koja pokušavaju uhvatiti korak s tehnologijom razgovarali smo s Larom Ljubičić, pravnom savjetnicom Udruge nakladnika informativnih publikacija (UNIP).
Objasnila nam je zašto činjenica da je sadržaj javno dostupan ne znači da je slobodan za korištenje, koliko autori i nakladnici danas stvarno mogu kontrolirati gdje završava njihov rad te zašto je generativni AI otvorio niz novih pravnih i ekonomskih pitanja.
Poseban izazov predstavlja treniranje AI modela. Izdavači često ne znaju je li njihov sadržaj prikupljen, u kojem je skupu podataka završio ni za koji je model korišten, zbog čega Ljubičić ističe potrebu za većom transparentnošću, jasnijim pravilima i pravednim modelima naknade.
A za manja tržišta poput hrvatskog, ulog je još veći.
U nastavku pročitajte cijeli intervju.
Imate rad koji zaslužuje SoMo nagrade?
Ako ste u protekloj godini radili na digitalnom projektu, kampanji ili sadržaju za koji vjerujete da zaslužuje pozornost struke, prijave za SoMo Borac 2026 još su otvorene.